---
title: 'KI-Funktionen'
description: 'Chat, Zusammenfassen, Stimme und Werkzeuge im Admin: was die KI kann und wo ihre Grenzen liegen.'
---
import { Aside, Tabs, TabItem, Steps } from '@astrojs/starlight/components';
Die KI im **tibi-admin** (Verwaltungs-Backend, Release Nova) hilft dir beim Redigieren: Sie chattet im Kontext der aktuellen Ansicht, fasst lange Verläufe zusammen, hört zu (STT) und liest vor (TTS). **Wichtig vorab: Im Frontend wählst du kein Modell** — alle Modellentscheidungen trifft der Proxy (`config/ai-proxy.config.json`); das Frontend ruft nur Endpunkte aus `frontend/assets/system.config.json` auf.
## Chat
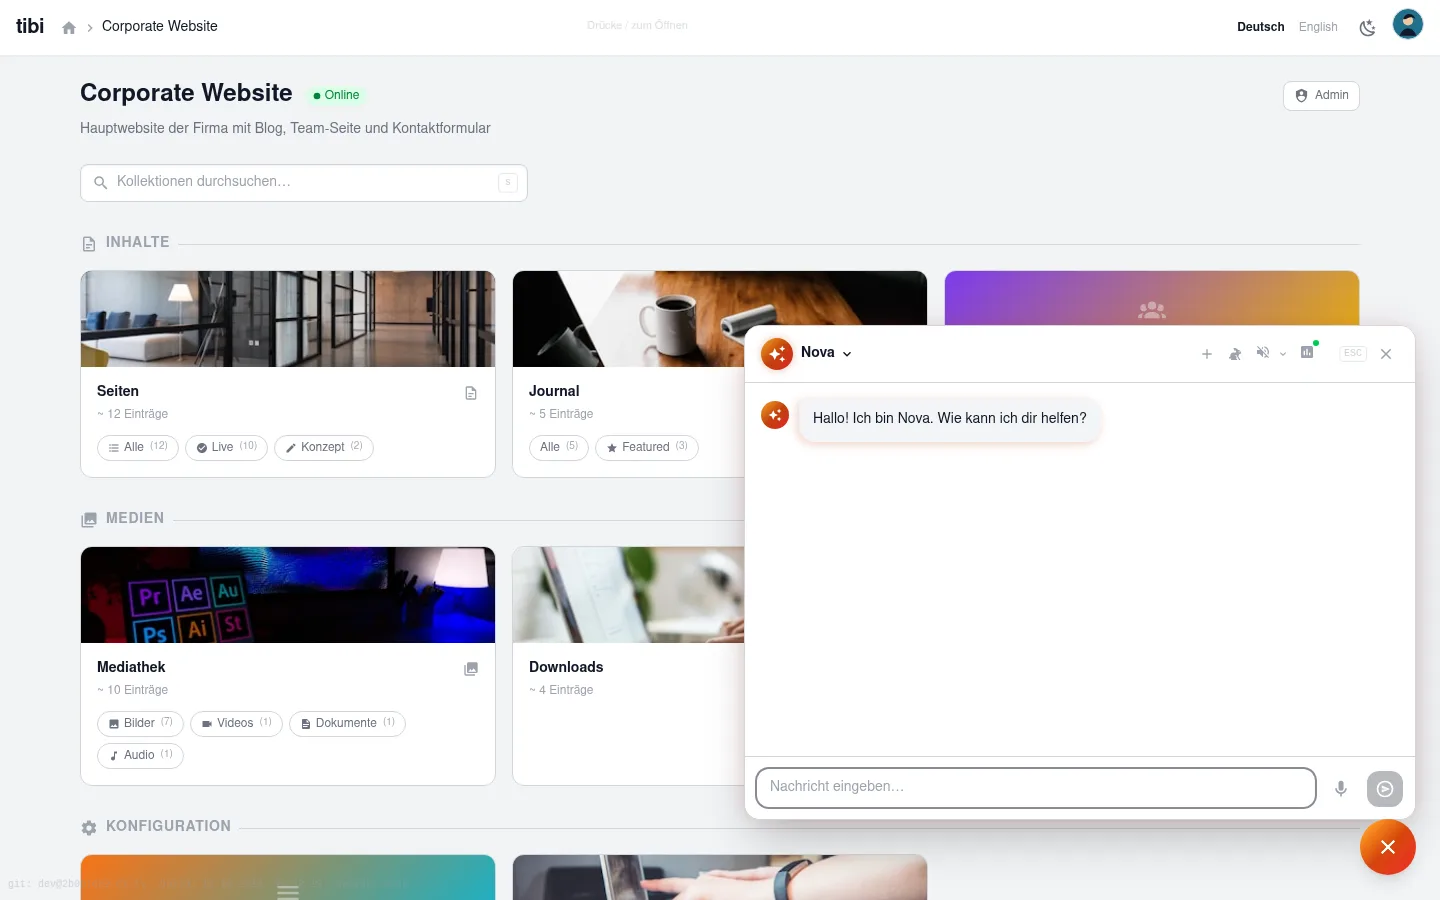
1. **„Nova öffnen“** klicken (`AiButton.svelte`) — der Chat (`AiChat.svelte`) öffnet sich mit Verlauf (`AiConversationList.svelte`). Begrüßung: „Hallo! Ich bin Nova. Wie kann ich dir helfen?“
2. Frage in **„Nachricht eingeben…“** stellen und **„Senden“** drücken — die KI sieht den aktuellen UI-Kontext (kompaktes JSON-Snapshot, < 500 Token).
3. Antwort prüfen: Werkzeug-Schritte zeigt `AiToolStatus.svelte`, Details der Aufrufe `AiToolInspector.svelte`.
4. Weiterfragen oder über **„Neuer Chat“** von vorn beginnen (`start_new_chat`-Werkzeug).
Was die KI dabei sieht (`aiController.ts`, `AiChat.svelte`): Neben dem UI-Snapshot hängt der Chat deine Aktionen außerhalb des Chats an die nächste Nachricht an (`[User actions performed outside of chat] … [User message] …`) und markiert die erste Nachricht mit `[lang=de]` (bzw. deiner Sprache). Manche Provider verlangen die Systemnachricht genau einmal vorn — deshalb wandern Aktionen in die Benutzer-Nachricht, nicht in eine zweite Systemnachricht.
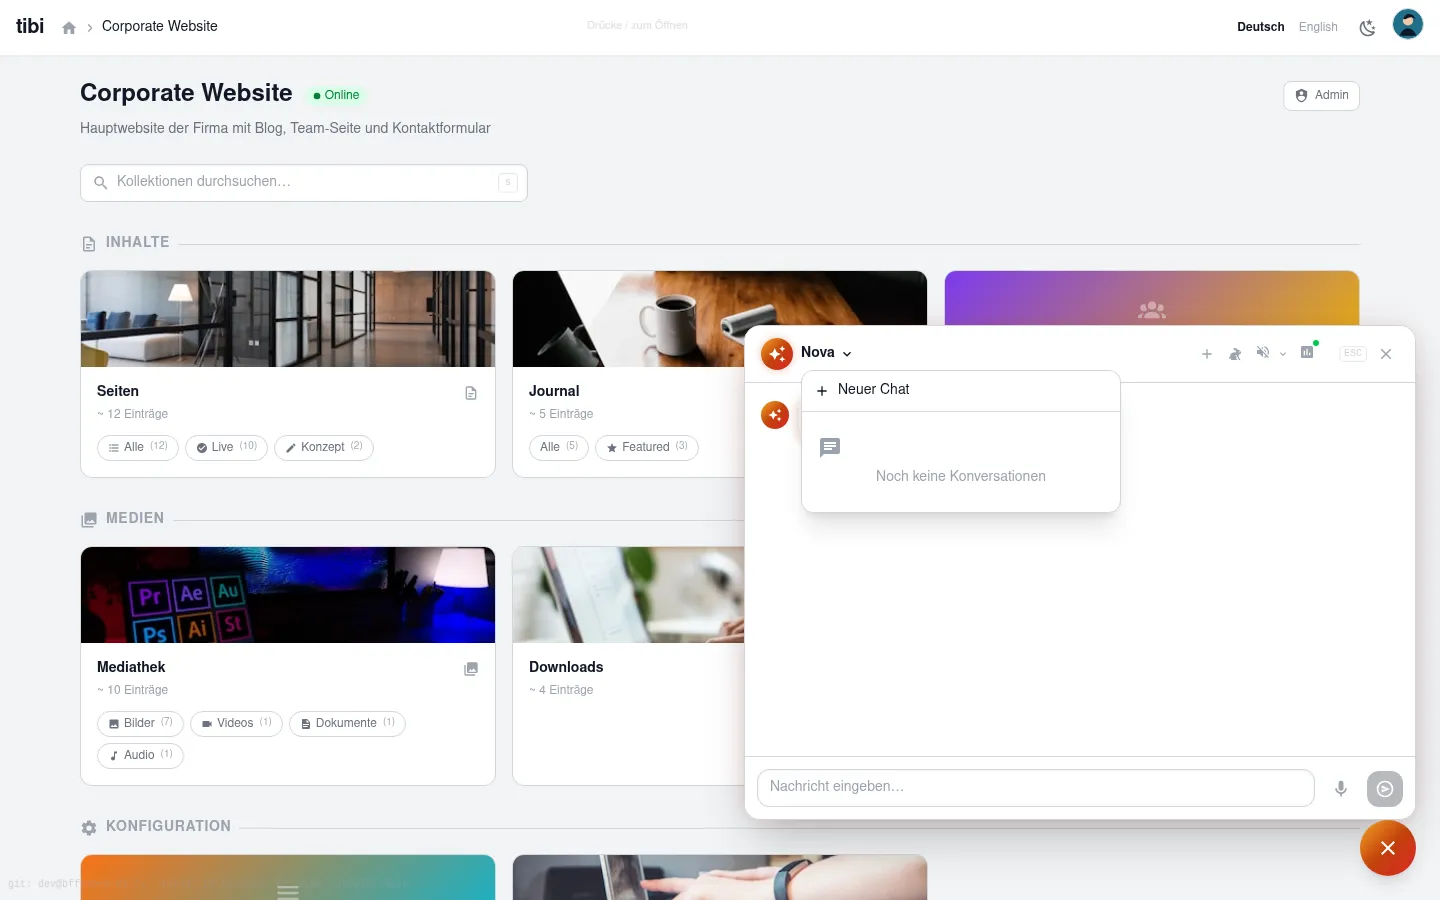
Über das Menü neben **Nova** verwaltest du den **Chat-Verlauf**: **Neuer Chat** beginnt ein leeres Gespräch, darunter listet der Admin gespeicherte Konversationen. Der Verlauf liegt nur lokal im Browser (`localStorage`); ohne gespeicherte Gespräche steht dort **Noch keine Konversationen**.
| Baustein | Datei | Aufgabe |
|---|---|---|
| Verlauf | `lib/aiChatHistory.ts` | Gespräche in `localStorage` (`tibi-ai-conversations`, weiches Limit ~4 MB, älteste zuerst raus) |
| Steuerung | `lib/aiController.ts` | Kontext lesen, Aktionen ausführen (nicht destruktiv; Heikles nur mit deiner Bestätigung), Cursor-Animation mit Tempo 0–3 |
| Werkzeug-Definitionen | `lib/aiTools.ts` | Funktionsaufrufe für den Chat (nächster Abschnitt) |
| Schätzung | `lib/aiTokenEstimator.ts` | Heuristik ~4 Zeichen ≈ 1 Token, nur für Vorab-Entscheidungen |
**„Token-Status“** (Knopf im Chat) öffnet ein Popover: Oben steht die **„Kontext-Auslastung“** in Prozent mit Farbstufe, darunter **„Letzter Turn“** (**„Prompt-Tokens“**, **„Completion-Tokens“**, **„Gesamt-Tokens“**, **„Geschätzte Kosten“**), **„Konversation gesamt“** (inkl. Zusammenfassungs-, Spracheingabe- und Sprachausgabe-Kosten) sowie **„Modell“** und **„Kontextfenster“**. Gezählt wird zweigleisig: Die Schätzung steuert Vorab-Entscheidungen, die echten Zähler kommen aus der Stream-Antwort und landen in **„Geschätzte Kosten“** über die Anzeigetabelle `TEXT_TOKEN_PRICING` — reine Anzeige, keine Abrechnung.
| Schwelle | Farbe | Bedeutung |
|---|---|---|
| unter 40 % | Grün | Reichlich Platz — normal weiterarbeiten |
| 40 bis unter 70 % | Gelb | Füllstand im Blick behalten |
| 70 bis unter 85 % | Orange | Bald zusammenfassen oder neuen Chat starten |
| ab 85 % | Rot | Kritisch — Zusammenfassen oder hartes Kürzen steht an |
Das **„Kontextfenster“** liest der Chat aus dem Modellkatalog (Endpunkt `/api/ai/models`, `configured.chat.contextWindow`); antwortet der Katalog nicht, gelten 96 000 Token (`MODEL_CONTEXT_WINDOW`). Aktuell meldet der Proxy 262 144 (siehe `config/ai-proxy.config.json`, `chat.contextWindow`).
Tempo der Cursor-Animation: **„Nova-Speed“** mit **„Hyperspeed“** (0, alles sofort), **„Schnell“** (1, Standard), **„Mittel“** (2), **„Langsam“** (3) — als Befehle (**„Nova-Speed: …“**) und Kennung `ai-animation-speed` in `localStorage`. Bei zu vielen Schritten stoppt Nova von selbst: „Automatisch gestoppt – zu viele aufeinanderfolgende Aktionen. Nova wurde nach {count} Schritten angehalten …“ — dann Anfrage neu formulieren oder Felder manuell prüfen.
## Zusammenfassen
Wächst ein Gespräch Richtung Kontextgrenze, komprimiert `lib/aiSummarizer.ts` in zwei Stufen:
| Stufe | Schwelle | Verhalten |
|---|---|---|
| Verdichten (kostenlos, synchron) | Mehr als 12 Werkzeug-Aktivitäten | `condenseHistoricalToolMessages`: abgeschlossene alte Werkzeug-Gruppen werden zu je einer Historie-Notiz (`[HISTORY-CONDENSED: …]`, Rolle `user`), die neuesten 12 Aktivitäten bleiben roh |
| Zusammenfassen per LLM | 60 % des Fensters (`SUMMARIZE_THRESHOLD`) | Ältere Nachrichten per LLM zusammenfassen, neueste ~6 Nachrichten (max. ~8 000 Token) roh behalten |
| Hart kürzen | 85 % (`HARD_TRUNCATE_THRESHOLD`) | Älteste Nachrichten verwerfen |
- Reserviert sind 10 000 Token für System-Prompt, Werkzeug-Definitionen und Antwort (`RESERVED_TOKENS`).
- Zusammenfassungs-Modell: `proxy-managed` — auch hier entscheidet der Proxy, nicht das Frontend. Der Aufruf geht an den Zusammenfassungs-Endpunkt mit Profil `summarizer` und liest einen SSE-Strom (inkl. Zähler); Antwort leer oder Netzfehler → Rückfall auf hartes Kürzen.
- Hartes Kürzen hält Werkzeug-Paare zusammen: Verwaiste `tool`-Antworten und `assistant`-Nachrichten ohne vollständige Ergebnisse fliegen raus (`hardTruncate`, `sanitizeWireMessages`) — sonst würde die API den Turn ablehnen.
- UI: Währenddessen steht **„Kontext wird zusammengefasst…“**, danach **„Kontext zusammengefasst“** bzw. **„Zusammenfassung aktiv“** mit **„{count} Nachrichten komprimiert · ~{tokens} Tokens gespart“**.
- Themenwechsel: Schlägt Nova einen neuen Chat vor (**„Neuen Chat starten?“** — **„Neuen Chat starten“** oder **„Nein, weiter“**), fasst `summarizeForTransfer` den ganzen Verlauf zusammen und stellt deine letzte Nachricht wörtlich unter „LATEST REQUEST“. Im neuen Chat erscheint das als **„Kontext aus vorherigem Chat“** (**„{count} Nachrichten aus vorherigem Chat · ~{tokens} Tokens übertragen“**).
## Stimme
**„Spracheingabe“** (`lib/aiVoiceInput.ts`, `VoiceRecorder`): Sprich deinen Prompt statt ihn zu tippen.
1. Mikro-Knopf drücken — zuerst versucht der Browser **native Spracherkennung** (Status **„Hört auf diesem Gerät“**, Sprache aus ``, Standard `de-DE`).
2. Klappt das nicht, zeichnet der Admin Audio auf (**„Nimmt für KI-Transkription auf“**) und schickt es an `/api/ai/transcribe` (Proxy-Modell `large-v3-turbo`, Antwort als Text — Status **„Transkribiert mit KI“** bzw. **„Erkennt auf diesem Gerät“**).
3. Das Transkript landet im Chat-Eingabefeld (**„Wird transkribiert…“** währenddessen); Dauer und Quelle (`browser`/`api`) stehen dabei. **„Aufnahme stoppen“** beendet manuell, **„Abbrechen“** verwirft.
Grenzen: Stille beendet automatisch nach 3 s (mobil 3,5 s, frühestens nach 600 ms Aufnahme); Schnipsel unter ~1 000 Byte werden ohne Transkription verworfen. Kostenkopf der Antwort (`X-AI-Cost-Usd`, `X-AI-Model`) zählt in **„Konversation gesamt“** unter **„Spracheingabe“**.
Antworten anhören statt lesen (`lib/aiTTS.ts`, Endpunkt `/api/ai/tts`) — Knopf **„Vorlesen“**, Stopp über **„Wiedergabe stoppen“** (**„Audio wird geladen…“** während des Ladens):
| Einstellung | Wert (`system.config.json`) |
|---|---|
| Stimmen | `eva-de` (Standard), `kerstin-de`, `ramona-de` |
| Tempo | **„Geschwindigkeit“** 0,5–2,0, Schritt 0,1, Standard **1,3** (**„Zurücksetzen“** stellt den Standard wieder her) |
| Format | MP3 (`responseFormat: mp3`) — Opus im WebM, wenn dein Browser es kann (`preferredTTSFormat`) |
Verhalten: Quelle zuerst Browser-**„Systemstimme auf diesem Gerät“** (passend zu deiner Dokumentsprache, Standard `de-DE`), sonst **„KI-Stimme“** (Proxy-Modell `qwen3-tts-0.6b-base`) — Anzeige **„Stimme: {voice}“**. Beim Streamen spricht Nova satzweise mit: erster Block ab ~60 Zeichen, danach ~120-Zeichen-Bündel, bis zu 2 parallele Anfragen, lückenlos aneinandergereiht. Schalter **„Sprachausgabe“** / **„Sprachausgabe aus“**; Zeichen und Kosten meldet der Server per Kopf (`X-AI-Characters`, `X-AI-Cost-Usd`) und landen unter **„Sprachausgabe“** in **„Konversation gesamt“**.
Zusatz: **Vision** (`/api/ai/vision`) beschreibt Bilder für CMS-Felder („erfinde keine nicht sichtbaren Fakten“); **Übersetzung** (`/api/ai/chat` mit System-Prompt) hält das angeforderte Ausgabeformat exakt ein.
## Werkzeuge
Die KI ruft UI-Werkzeuge statt zu raten (`aiTools.ts` → `aiController.ts`). Labels wörtlich aus `de.json` (`admin.ai.tools.*`); Status dazu: **„Arbeitet…“** währenddessen, danach **„1 Aktion ausgeführt“** bzw. **„{count} Aktionen ausgeführt“**, **„Details“** öffnet den **„Tool-Inspector“** (**„Tool-Aufruf“** / **„Tool-Rückgabe“**, **„Formatiert“** / **„Roh“**, **„Alle Schritte kopieren“**):
| Gruppe | Werkzeuge (UI-Name) |
|---|---|
| Navigation | `navigate` (**„Navigieren“**), `guide_to` (**„Geführte Tour“**), `list_projects` (**„Projekte auflisten“**), `select_project` (**„Projekt öffnen“**), `select_collection` (**„Collection öffnen“**) |
| Liste | `search` (**„Suchen“**), `set_search_mode` (**„Suchmodus wechseln“**), `set_filter` (**„Filter setzen“**), `clear_filters` (**„Filter löschen“**), `sort_by` (**„Sortieren“**), `set_page` (**„Seite wechseln“**), `set_page_size` (**„Seitengröße ändern“**) |
| Auswahl | `select_records` (**„Datensätze auswählen“**), `select_all` (**„Alle auswählen“**), `deselect_all` (**„Auswahl aufheben“**), `open_collection_record` (öffnet den Datensatz, Tool-Name als Anzeige), `set_view_mode` (**„Ansicht wechseln“**) |
| Stapel | `open_bulk_edit` (**„Massenbearbeitung“**), `prepare_bulk_delete` (**„Löschung vorbereiten“**) |
| Eintrag & Formular | `get_entry_context` (**„Eintrag-Kontext abrufen“**), `fill_field` (**„Feld ausfüllen“**), `fill_form` (**„Formular ausfüllen“**), `focus_field` (**„Feld fokussieren“**), `save_entry` (**„Eintrag speichern“**), `cancel_entry` (**„Bearbeitung abbrechen“**), `create_entry` (**„Neuen Eintrag anlegen“**), `duplicate_entry` (**„Eintrag duplizieren“**) |
| Array-Felder | `add_array_item` (**„Array-Element hinzufügen“**), `remove_array_item` (**„Array-Element entfernen“**), `duplicate_array_item` (**„Array-Element duplizieren“**), `reorder_array_items` (**„Array-Elemente sortieren“**), `clear_array` (**„Array leeren“**) |
| Verknüpfungen | `search_foreign_options` (**„Verknüpfte Einträge durchsuchen“**), `create_foreign_entry` (**„Verknüpften Eintrag erstellen“**) |
| Navigation (Inhalt) | `open_navigation_node` (**„Navigationsknoten öffnen“**), `add_navigation_node` (**„Navigationsknoten hinzufügen“**), `move_navigation_node` (**„Navigationsknoten verschieben“**), `delete_navigation_node` (**„Navigationsknoten löschen“**) |
| Medien | `upload_media` (**„Medien hochladen“**), `quick_upload_all` (**„Alle schnell hochladen“**), `edit_image` (**„Bild bearbeiten“**), `inline_edit_title` (**„Medieneintrag öffnen“**), Warteschlange: `list_queue_items` (**„Warteschlange anzeigen“**), `edit_queue_item` (**„Element bearbeiten“**) |
| Verlauf | `get_audit_history` (**„Verlauf abrufen“**), `list_audit_log` (**„Audit-Log anzeigen“**), `restore_from_audit` (**„Aus Audit übernehmen“**) |
| Oberfläche | `toggle_sidebar` (Seitenleiste, Tool-Name als Anzeige), `open_field_search` (Feldsuche, Tool-Name als Anzeige), `set_theme` (**„Theme wechseln"**), `switch_language` (**„Sprache wechseln"**), `highlight_element` (**„Element hervorheben"**), `explain_ui` (**„UI erklären"**), `list_ui_elements` (**„UI-Elemente auflisten"**), `click_element` (**„Element klicken"**), `drill_navigate` (Ansicht lesen, Tool-Name als Anzeige) |
| Daten lesen | `get_collection_records` (Datensätze lesen, Tool-Name als Anzeige), `get_collection_schema` (Schema lesen, Tool-Name als Anzeige), `list_users` (**„Benutzer auflisten"**) |
| Chat | `start_new_chat` (**„Neuer Chat“**), `run_tool_batch` (**„Batch ausführen“**) |
Stapel-Limits (`aiTools.ts`): `run_tool_batch` fasst bis zu 40 ändernde Schritte (100 bei rein lesenden wie **„Kontext abrufen“**, **„Projekte auflisten“**, **„Benutzer auflisten“**) — darüber verweigert der Batch. `get_context` (**„Kontext abrufen“**) und `get_entry_context` lesen gezielt nach: Standardablauf ist erst Eintrag öffnen, dann `get_entry_context`, dann die Feld-Updates möglichst als ein Batch.
## Grenzen und Kosten
Wichtig zur Einordnung: Der Admin-Chat läuft über den Proxy (`/api/ai/chat`, `/api/ai/vision`, `/api/ai/transcribe`, `/api/ai/tts`) — **nicht** über `POST /api/v1/llm/chat` am tibi-server. Die Benutzer-/Org-Budgets mit `429` aus [LLM nutzen](/projekt/llm-nutzen/) greifen daher hier nicht; was hier begrenzt, steht in `config/ai-proxy.config.json` und `frontend/assets/system.config.json`:
| Punkt | Stand |
|---|---|
| Modellwahl | Gibt es im Frontend nicht — Proxy-Config entscheidet (Chat, Zusammenfassen, Übersetzung, Vision je eigenes Modell/Fenster) |
| Preise im Proxy | Aktuell `0` (interne Test-Modelle: alle `pricing`-Felder `0`); die Schätztabelle im Frontend (`TEXT_TOKEN_PRICING`) dient nur der Anzeige im **„Token-Status“** |
| Fenster & Antwortlänge | Chat 262 144 / max. 12 000 Token, Zusammenfassen und Übersetzung je 262 144 / 6 000, Vision 32 768 / 6 000 |
| Verlauf | Nur lokal im Browser (`localStorage`: `tibi-ai-conversations`, weich ~4 MB — älteste zuerst raus; Single-Chat-Notbremse: nur letzte 4 Wire-Nachrichten bleiben) |
| Stapel | `run_tool_batch`: max. 40 ändernde bzw. 100 rein lesende Schritte |
| Sprache | 3 s Stille beendet (mobil 3,5 s), Schnipsel < ~1 KB verfallen; TTS-Bündel ab ~60/120 Zeichen |
| Offline | Ohne Server keine KI — Chat, STT, TTS brauchen ihre Endpunkte |
| Fehlerbild | Ursache | Lösung |
|---|---|---|
| Chat antwortet nicht | Endpunkt `/api/ai/chat` unerreichbar oder Proxy down | [Admin einrichten](/admin/setup/) prüfen, später erneut versuchen |
| **„KI-Dienst ist nicht erreichbar. Bitte versuche es später erneut.“** | Endpunkt fehlt (404) oder Proxy liefert JSON statt Nutzdaten | [Admin einrichten](/admin/setup/) prüfen |
| **„KI-Dienst nicht konfiguriert. Bitte kontaktiere den Administrator.“** | 401/403 am Proxy (Schlüssel/Config) | Administrator ansprechen |
| **„Rate-Limit erreicht. Bitte warte einen Moment und versuche es erneut.“** | 429 am Proxy | Kurz warten, erneut versuchen |
| **„Der KI-Dienst ist vorübergehend nicht erreichbar. Bitte versuche es später erneut.“** | 5xx am Proxy | Später erneut versuchen |
| **„Mikrofon-Zugriff verweigert. …“** | Browser-Recht fehlt | Mikrofon in den Browser-Einstellungen freigeben |
| **„Transkription fehlgeschlagen: {error}“** | Rate-Limit, Netz oder Proxy-Fehler | Kürzeren Abschnitt sprechen, erneut versuchen |
| Stimme klingt falsch | Andere Stimme aktiv | Stimme in den KI-Einstellungen zurück auf `eva-de` setzen |
Verifiziert am 2b091d8 2026-10-17 (tibi-admin-nova: AiChat/AiButton/AiConversationList/AiToolStatus/AiToolInspector/AiDebugContext, aiChatHistory/aiController/aiTools/aiTokenEstimator/aiVoiceInput/aiSummarizer/aiTTS/aiModelCatalog, config/ai-proxy.config.json, frontend/assets/system.config.json, de.json admin.ai + Befehle)